Python 实现高德 GCJ-02 转百度 BD-09:MySQL 批量并发处理与断点续跑
在实际的数据治理、地图数据迁移以及零售户地理信息处理中,经常会遇到不同地图厂商之间的坐标系不一致问题。

例如:
- 高德地图使用 GCJ-02
- 百度地图使用 BD-09
- GPS 原始坐标通常为 WGS-84
如果数据库中的经纬度来自高德地图,而后续业务需要使用百度地图进行展示、空间计算或者区域匹配,就需要先将 GCJ-02 坐标转换为 BD-09。
当数据量比较小时,可以直接逐条转换。
但是如果数据库中有几十万、几百万甚至上千万条坐标数据,逐条处理会非常慢。
本文介绍一种适合实际生产环境的处理方式:
MySQL + Python + 多进程并发 + 批量读取 + 批量更新 + 断点续跑
一、问题背景
假设数据库中存在一张零售户位置表:
CREATE TABLE `t_data_cust` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `cus_name` varchar(255) DEFAULT NULL COMMENT '零售户名称',
  `address` varchar(255) DEFAULT NULL COMMENT '经营地址',
  `mapx` float DEFAULT NULL COMMENT '经度',
  `mapy` float DEFAULT NULL COMMENT '纬度',
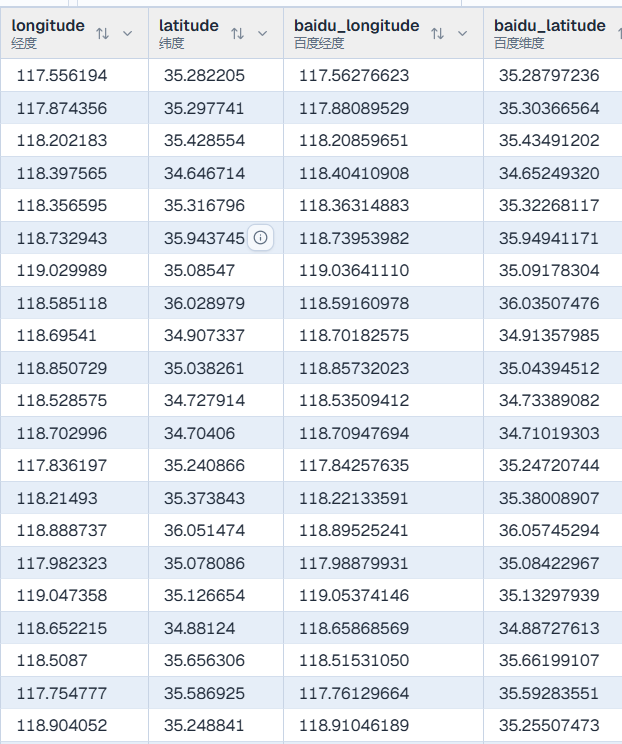
  `baidu_longitude` double DEFAULT NULL COMMENT '百度经度',
  `baidu_latitude` double DEFAULT NULL COMMENT '百度纬度',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
其中:
mapx = 高德经度
mapy = 高德纬度
数据类似:
id       mapx          mapy
1        119.036411    35.091783
2        119.027665    35.096810
3        119.024164    35.094040
现在需要将:
GCJ-02
   ↓
BD-09
转换以后保存到:
baidu_longitude
baidu_latitude
二、GCJ-02 和 BD-09 是什么?
在中国互联网地图应用中,经常会接触到几个坐标系。
WGS-84
GPS 常见的全球坐标系。
例如:
119.000000
35.000000
GCJ-02
高德地图、腾讯地图等国内地图服务常见的坐标系。
BD-09
百度地图在 GCJ-02 基础上再次进行偏移后的坐标系。
因此:
WGS-84
   ↓
GCJ-02
   ↓
BD-09
本文只讨论:
GCJ-02 → BD-09
三、GCJ-02 转 BD-09 算法
GCJ-02 转 BD-09 可以直接使用公开的数学转换公式。
Python 实现如下:
import math


def gcj02_to_bd09(lng, lat):
    """
    GCJ-02 转 BD-09

    :param lng: GCJ-02 经度
    :param lat: GCJ-02 纬度
    :return: BD-09 经度、纬度
    """

    x = lng
    y = lat

    z = math.sqrt(x * x + y * y) + \
        0.00002 * math.sin(y * math.pi * 3000.0 / 180.0)

    theta = math.atan2(y, x) + \
            0.000003 * math.cos(x * math.pi * 3000.0 / 180.0)

    bd_lng = z * math.cos(theta) + 0.0065
    bd_lat = z * math.sin(theta) + 0.006

    return bd_lng, bd_lat
测试:
lng = 119.03641110
lat = 35.09178304

bd_lng, bd_lat = gcj02_to_bd09(lng, lat)

print(bd_lng)
print(bd_lat)
四、为什么不能直接逐条查询和更新?
最简单的代码可能是:
for row in rows:

    lng = row["mapx"]
    lat = row["mapy"]

    bd_lng, bd_lat = gcj02_to_bd09(lng, lat)

    cursor.execute(
        """
        UPDATE t_data_cust
        SET baidu_longitude = %s,
            baidu_latitude = %s
        WHERE id = %s
        """,
        (bd_lng, bd_lat, row["id"])
    )
这种方式存在两个明显问题。
1. 数据库交互次数太多
假设有:
1,000,000 条数据
就可能产生:
1,000,000 次 UPDATE
数据库压力比较大。
2. 单线程速度比较慢
即使坐标转换本身非常快:
读取数据库
    ↓
计算
    ↓
UPDATE
    ↓
读取下一条
    ↓
计算
    ↓
UPDATE
整个过程是串行的。
五、优化思路
可以把整个处理过程拆成几个阶段:
MySQL
  │
  │ 批量读取
  ↓
Python
  │
  ├── 进程1
  ├── 进程2
  ├── 进程3
  ├── 进程4
  ├── 进程5
  └── 进程6
  │
  │ GCJ-02 → BD-09
  ↓
批量结果
  │
  ↓
MySQL 批量 UPDATE
核心思想是:
数据库负责数据存储,CPU 多进程负责坐标计算。
六、为什么使用多进程?
Python 中普通的多线程受到 GIL 的影响。
虽然这个坐标转换计算量不算特别大,但是如果数据达到几十万、几百万条,多进程能够更加充分地利用多个 CPU 核心。
例如:
单进程

CPU
└── Python
    └── 处理所有数据
改成:
6 个进程

CPU
├── Process 1
├── Process 2
├── Process 3
├── Process 4
├── Process 5
└── Process 6
每个进程处理自己的一批数据。
七、批量并发处理
下面给出一个完整示例。
首先安装依赖:
pip install mysql-connector-python
如果使用 Conda:
conda activate 你的环境
python -m pip install mysql-connector-python
八、完整代码
import math
import mysql.connector

from concurrent.futures import ProcessPoolExecutor
from mysql.connector import Error


# ============================================================
# MySQL 配置
# ============================================================

DB_CONFIG = {
    "host": "127.0.0.1",
    "port": 3306,
    "user": "root",
    "password": "123456",
    "database": "test",
}


# ============================================================
# GCJ-02 → BD-09
# ============================================================

def gcj02_to_bd09(lng, lat):

    x = lng
    y = lat

    z = math.sqrt(x * x + y * y) + \
        0.00002 * math.sin(
            y * math.pi * 3000.0 / 180.0
        )

    theta = math.atan2(y, x) + \
            0.000003 * math.cos(
                x * math.pi * 3000.0 / 180.0
            )

    bd_lng = z * math.cos(theta) + 0.0065
    bd_lat = z * math.sin(theta) + 0.006

    return bd_lng, bd_lat


# ============================================================
# 单个任务
# ============================================================

def process_batch(batch):

    result = []

    for row in batch:

        row_id = row[0]
        lng = row[1]
        lat = row[2]

        try:

            bd_lng, bd_lat = gcj02_to_bd09(
                float(lng),
                float(lat)
            )

            result.append(
                (
                    bd_lng,
                    bd_lat,
                    row_id
                )
            )

        except Exception as e:

            print(
                f"ID={row_id} 转换失败:{e}"
            )

    return result


# ============================================================
# 创建数据库连接
# ============================================================

def get_connection():

    return mysql.connector.connect(
        host=DB_CONFIG["host"],
        port=DB_CONFIG["port"],
        user=DB_CONFIG["user"],
        password=DB_CONFIG["password"],
        database=DB_CONFIG["database"],
    )


# ============================================================
# 获取待处理数据
# ============================================================

def get_data():

    conn = None
    cursor = None

    try:

        conn = get_connection()

        cursor = conn.cursor()

        sql = """
        SELECT
            id,
            mapx,
            mapy
        FROM t_data_cust
        WHERE mapx IS NOT NULL
          AND mapy IS NOT NULL
          AND baidu_longitude IS NULL
          AND baidu_latitude IS NULL
        """

        cursor.execute(sql)

        rows = cursor.fetchall()

        print(f"待处理数据:{len(rows)} 条")

        return rows

    finally:

        if cursor:
            cursor.close()

        if conn:
            conn.close()


# ============================================================
# 批量更新数据库
# ============================================================

def update_database(results):

    if not results:
        return

    conn = None
    cursor = None

    try:

        conn = get_connection()

        cursor = conn.cursor()

        sql = """
        UPDATE t_data_cust
        SET
            baidu_longitude = %s,
            baidu_latitude = %s
        WHERE id = %s
        """

        cursor.executemany(
            sql,
            results
        )

        conn.commit()

        print(
            f"数据库更新完成:{len(results)} 条"
        )

    except Exception:

        if conn:
            conn.rollback()

        raise

    finally:

        if cursor:
            cursor.close()

        if conn:
            conn.close()


# ============================================================
# 主程序
# ============================================================

def main():

    print("=" * 60)
    print("GCJ-02 → BD-09 批量并发转换")
    print("=" * 60)

    # 读取数据
    rows = get_data()

    if not rows:

        print("没有需要处理的数据")

        return

    # ========================================================
    # 分批
    # ========================================================

    batch_size = 5000

    batches = []

    for i in range(
        0,
        len(rows),
        batch_size
    ):

        batch = rows[
            i:i + batch_size
        ]

        batches.append(batch)

    print(
        f"数据总量:{len(rows)}"
    )

    print(
        f"批次数量:{len(batches)}"
    )

    # ========================================================
    # 并发处理
    # ========================================================

    max_workers = 6

    print(
        f"并发进程数:{max_workers}"
    )

    all_results = []

    with ProcessPoolExecutor(
        max_workers=max_workers
    ) as executor:

        results = executor.map(
            process_batch,
            batches
        )

        for result in results:

            all_results.extend(result)

            print(
                f"当前已计算:{len(all_results)} 条"
            )

    print(
        f"坐标转换完成:{len(all_results)} 条"
    )

    # ========================================================
    # 批量更新数据库
    # ========================================================

    update_database(
        all_results
    )

    print("=" * 60)
    print("全部处理完成")
    print("=" * 60)


if __name__ == "__main__":

    main()
九、为什么这里使用 5000 条作为一个批次?
代码中:
batch_size = 5000
假设有:
100000 条数据
那么会被拆成:
5000
5000
5000
...
总共:
20 个任务
然后交给:
ProcessPoolExecutor(max_workers=6)
处理。
实际效果类似:
批次1 ──→ 进程1
批次2 ──→ 进程2
批次3 ──→ 进程3
批次4 ──→ 进程4
批次5 ──→ 进程5
批次6 ──→ 进程6

批次7 ──→ 空闲进程
批次8 ──→ 空闲进程
...
十、为什么不建议一次创建几十万个任务?
例如:
executor.submit(
    gcj02_to_bd09,
    lng,
    lat
)
然后创建:
1000000 个 Future
这种方式会增加:
- Python 内存占用
- Future 对象数量
- 进程通信开销
- 调度开销
因此更适合:
批量提交任务,而不是一条数据一个任务。
十一、六并发应该如何设置?
如果机器 CPU 比较强,可以:
max_workers = 6
例如:
6 个 CPU 工作进程
如果服务器是:
8 核
可以测试:
max_workers = 6
或者:
max_workers = 8
但是并不是进程越多越快。
例如:
4进程 → 100秒
6进程 → 75秒
8进程 → 72秒
12进程 → 78秒
可能出现这种情况。
原因是进程之间存在:
CPU 调度
进程通信
内存
数据库
等额外开销。
因此建议实际测试。
十二、更加重要:支持断点续跑
实际生产环境中,数据量比较大的时候,程序不一定一次就能跑完。
例如:
总数据:4,700,000

第一次:
处理 1,500,000
程序异常退出

第二次:
继续处理剩余数据
这时候:
WHERE baidu_longitude IS NULL
  AND baidu_latitude IS NULL
就非常重要。
因为已经处理完成的数据:
baidu_longitude IS NOT NULL
baidu_latitude IS NOT NULL
下一次不会再次处理。
也就是说:
第一次运行

100万
 ↓
转换
 ↓
写入百度坐标


第二次运行

查询百度坐标为空的数据
 ↓
继续处理
这实际上就是一种非常简单的:
断点续跑机制。
十三、处理过程中程序中断怎么办?
假设:
总数据:1,000,000
程序运行到:
600,000
突然:
电脑重启
网络断开
程序异常
如果前面的数据已经提交到数据库:
baidu_longitude
baidu_latitude
已经存在。
重新运行:
WHERE baidu_longitude IS NULL
  AND baidu_latitude IS NULL
那么只会获取剩余数据。
例如:
第一次

1,000,000
 ↓
600,000 已完成


第二次

400,000
 ↓
继续处理
因此不需要重新计算全部数据。
十四、不要把所有结果一直放在内存中
上面的示例为了方便理解:
all_results = []
然后把所有结果放到内存。
如果只有:
4万条
10万条
几十万条
问题一般不大。
但是如果是:
500万
1000万
就不建议这样做。
更加适合:
读取一批
 ↓
并发计算
 ↓
立即写数据库
 ↓
释放内存
 ↓
读取下一批
也就是:
MySQL
 ↓
50000
 ↓
并发计算
 ↓
UPDATE
 ↓
50000
 ↓
并发计算
 ↓
UPDATE
这样内存更加稳定。
十五、百万级数据推荐的架构
如果数据量达到百万级甚至千万级,可以进一步改成:
                  MySQL
                    │
                    ↓
              分批读取 50000
                    │
                    ↓
        ┌─────────────────────┐
        │  ProcessPoolExecutor│
        │                     │
        │ P1  P2  P3  P4     │
        │ P5  P6              │
        └─────────────────────┘
                    │
                    ↓
              转换结果
                    │
                    ↓
             executemany()
                    │
                    ↓
                  MySQL
                    │
                    ↓
              下一批数据
这样不会因为一次加载全部数据导致内存暴涨。
十六、一个非常重要的问题:坐标系必须一致
做空间计算时,这一点非常重要。
例如:
市场区域边界
    ↓
BD-09

零售户
    ↓
GCJ-02
那么不能直接:
Point(mapx, mapy)
然后和 BD-09 Polygon 判断。
因为两个坐标系不是同一个坐标系。
正确方式应该是:
零售户 GCJ-02
      │
      ↓
GCJ-02 → BD-09
      │
      ↓
零售户 BD-09
      │
      ↓
与市场区域 BD-09 Polygon 计算
例如:
bd_lng, bd_lat = gcj02_to_bd09(
    mapx,
    mapy
)

point = Point(
    bd_lng,
    bd_lat
)
然后再进行:
polygon.covers(point)
十七、为什么推荐 covers() 而不是 contains()?
如果进行市场区域空间匹配:
polygon.contains(point)
有一个问题。
如果零售户刚好位于:
Polygon 边界线上
那么:
contains()
可能返回:
False
而:
polygon.covers(point)
会把边界上的点也计算进去。
对于“一个零售户属于哪个市场区域”这种业务:
polygon.covers(point)
通常更加符合业务需求。
十八、为什么需要注意边界点?
例如:
       A────────B
      /          \
     /            \
    C      ●       D
     \            /
      \          /
       E────────F
如果:
● = 零售户
那么可以判断:
polygon.covers(point)
如果零售户刚好落在:
A-B
这条边界线上,也可以统计到该区域。
十九、后续可以进一步使用 STRtree 加速
如果不仅需要坐标转换,还需要:
市场区域 Polygon
+
几十万个零售户
进行空间匹配。
不要让每个零售户遍历全部 Polygon:
for customer in customers:

    for polygon in polygons:

        if polygon.covers(customer):
            ...
假设:
100000 个零售户
10000 个区域
理论上可能产生:
100000 × 10000
=
10亿次判断
这会非常慢。
可以使用 Shapely 的:
STRtree
建立空间索引:
from shapely.strtree import STRtree

tree = STRtree(polygons)
然后:
candidate_indexes = tree.query(point)
先找出空间上可能相交的 Polygon,再进行:
polygon.covers(point)
这样可以显著减少实际判断次数。
二十、一个完整的数据处理架构
最终可以形成:
                MySQL
                  │
        ┌─────────┴─────────┐
        │                   │
        ↓                   ↓
  零售户坐标             区域边界
  GCJ-02                  BD-09
        │                   │
        ↓                   │
 GCJ-02 → BD-09             │
        │                   │
        ↓                   ↓
   BD-09 Point        BD-09 Polygon
        │                   │
        └─────────┬─────────┘
                  ↓
              STRtree
                  │
                  ↓
            空间匹配
                  │
                  ↓
          统计每个区域户数
                  │
                  ↓
       t_comm_area_info.now_num
二十一、生产环境建议
如果数据量比较大,建议遵循以下原则。
1. 不要一次读取全部数据
使用:
5000
10000
50000
等批次。
2. 并发数不要盲目提高
例如:
max_workers = 6
先测试。
根据 CPU、内存和实际耗时再调整。
3. 数据库更新使用 executemany
不要:
UPDATE
UPDATE
UPDATE
UPDATE
而是:
cursor.executemany(
    sql,
    results
)
减少数据库交互。
4. 增加断点续跑条件
例如:
WHERE baidu_longitude IS NULL
  AND baidu_latitude IS NULL
5. 转换结果建议使用 DOUBLE
不要使用:
FLOAT
保存高精度经纬度时建议:
DOUBLE
例如:
baidu_longitude DOUBLE DEFAULT NULL,
baidu_latitude DOUBLE DEFAULT NULL
二十二、最终效果
经过优化以后,整体处理流程从:
查询一条
 ↓
转换一条
 ↓
更新一条
 ↓
查询一条
 ↓
转换一条
 ↓
更新一条
优化成:
批量查询
    ↓
    ↓
┌───────────────┐
│ 6进程并发计算 │
└───────────────┘
    ↓
批量结果
    ↓
executemany
    ↓
MySQL
    ↓
下一批
核心优化点可以总结为:
| 优化方式 | 作用 |
|---|---|
| 批量查询 | 减少数据库交互 |
| 多进程 | 提高 CPU 利用率 |
| 批量计算 | 减少进程调度开销 |
| executemany | 减少 UPDATE 次数 |
| NULL 判断 | 支持断点续跑 |
| DOUBLE | 保存更高精度 |
| GCJ-02 → BD-09 | 保证坐标系一致 |
| STRtree | 加速大量空间匹配 |
covers() |
将边界上的点纳入统计 |
对于几十万到几百万条坐标数据,这种方式比单条查询、单条计算、单条 UPDATE 更适合实际的数据处理任务。
总结
高德坐标转换成百度坐标,本身并不复杂,真正影响大数据处理效率的主要是:
数据库读取方式
        +
任务拆分方式
        +
并发模型
        +
数据库写入方式
        +
断点续跑
因此推荐采用:
MySQL
  ↓
批量读取
  ↓
ProcessPoolExecutor
  ↓
6进程并发
  ↓
GCJ-02 → BD-09
  ↓
批量 UPDATE
  ↓
继续下一批
如果后续还需要将转换后的百度坐标用于市场网格、村级区域、许可证布局等空间区域匹配,可以继续结合 Shapely + STRtree,实现:
零售户坐标
    ↓
百度坐标
    ↓
判断所在区域 Polygon
    ↓
统计每个村/网格零售户数量
    ↓
更新 t_comm_area_info.now_num
这样就可以从单纯的“坐标转换程序”,进一步扩展成完整的零售户空间数据治理和市场网格分析程序。